O aviso apareceu no meu próprio sistema. O índice de memória persistente dos meus agentes, um arquivo único de ponteiros que carrego entre sessões, passou de 24 KB e o harness começou a avisar que só parte dele tinha sido carregada. Ali eu vi na prática o que a literatura chama de memory pressure: a memória tinha crescido além do orçamento de contexto, e a solução não era janela maior. Era arquitetura.
Escrevi no episódio anterior desta série que janela de 1 milhão de tokens não resolve nada se a informação cai no meio. Este episódio ataca a pergunta anterior a essa: o que nunca deveria estar na janela? Memória de agente não é enfiar tudo no prompt. É decidir explicitamente o que entra no contexto neste turno, o que fica guardado fora dele, e como manter o que ficou fora coerente ao longo do tempo. As três arquiteturas que estudei atacam cada uma um pedaço disso.
Letta: o contexto como sistema operacional
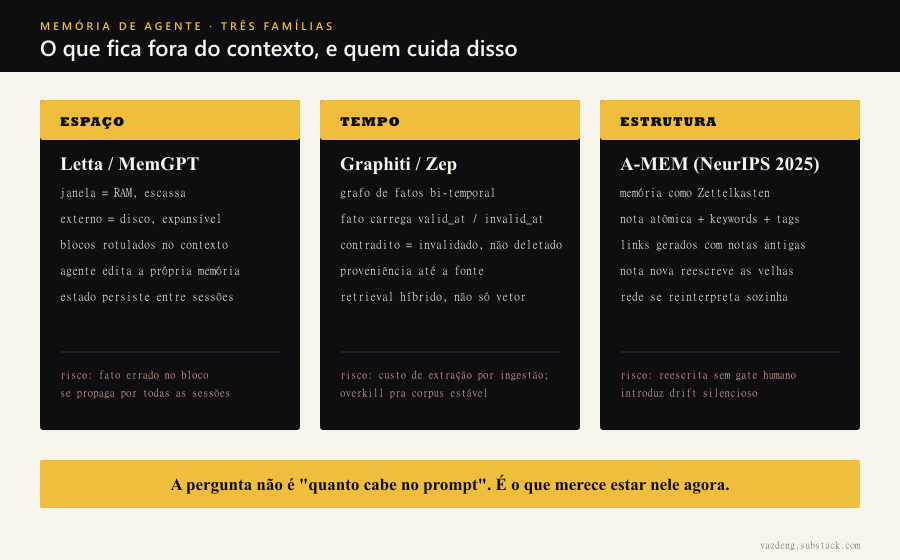
O Letta, herdeiro do paper MemGPT, usa uma analogia que gruda: a janela de contexto é a RAM, acesso imediato e espaço escasso. O armazenamento externo é o disco, persistente e expansível. A memória vive em blocos rotulados que ficam dentro do contexto, sempre visíveis ao modelo, e o próprio agente pode editá-los via tools. O resto vai pro arquivo externo e só sobe quando a tarefa pede.
Eu uso essa distinção manualmente há meses sem saber o nome: meu índice de memória é o bloco que vive no contexto, curto e feito de ponteiros. O detalhe mora em arquivos por tópico, puxados sob demanda. Quando o índice estourou os 24 KB, a lição do Letta era literal: o que fica na mesa tem que ser pequeno, o resto volta pra gaveta.
O risco que ninguém conta: self-editing memory significa que o agente pode corromper o próprio estado. Um fato errado escrito no bloco persistente se propaga por todas as sessões seguintes. Estado editável pede validação e versionamento.
Graphiti: fatos que vencem
O Graphiti, motor open-source do Zep, resolve outro problema: fato tem prazo de validade. Cada fato no grafo carrega valid_at e invalid_at. Quando um fato novo contradiz um antigo, o sistema invalida o velho em vez de apagar. A Selic de hoje não é a de março, mas a pergunta “qual era a taxa em março” continua respondível, porque o fato vencido segue lá, carimbado.
Esse desenho muda a pergunta do retrieval. Buscar “o trecho mais parecido” devolve o fato mais parecido, que pode ser o fato expirado. Buscar num grafo bi-temporal devolve o fato válido agora, com trilha de proveniência até a fonte. Pra agente que lida com dado financeiro, jurídico ou de política interna, essa diferença é o produto inteiro.
A-MEM: a memória que se reescreve
O A-MEM, publicado no NeurIPS 2025, organiza memória como um Zettelkasten: cada entrada vira nota atômica com descrição, keywords e tags, o sistema gera links com as notas históricas relevantes, e a chegada de informação nova pode atualizar a representação das notas antigas. A memória não só cresce. Ela se religa e se reinterpreta.
Mantenho um segundo cérebro assim há 6 anos, mais de 2.700 notas e quase 21 mil links, e por isso o A-MEM me convence e me assusta na mesma medida. Deixar um LLM reescrever notas antigas sem gate humano introduz drift silencioso: a nuance que você escreveu some numa “melhoria” que ninguém revisou. O padrão vale, a autonomia total não. Aqui, quem aprova a reescrita sou eu.
Quando não usar
Tarefa de um turno não precisa de nada disso: se não há continuidade entre sessões, gerenciar RAM e disco é custo sem retorno. Corpus pequeno e estável de fatos dispensa grafo temporal, um timestamp ao lado do dado resolve. E memory evolution sem aprovação humana é aposta que eu não faço em base que serve de fonte de verdade.
O resumo que levo pros meus projetos: Letta gerencia espaço, Graphiti gerencia tempo, A-MEM gerencia estrutura. Os três respondem a mesma pergunta por ângulos diferentes, e a pergunta não é “quanto cabe no prompt”. É “o que merece estar nele agora, e quem cuida do resto”.