Quando escrevi em junho que prompt injection é o SQL injection da IA, a pergunta que ficou em aberto foi a mais óbvia: então como se defende? Passei as semanas seguintes procurando uma resposta que não fosse “escreva um system prompt mais firme”, e a resposta honesta do mercado em 2026 é desconfortável. Você não defende impedindo a injeção. Você defende tornando a injeção inútil.
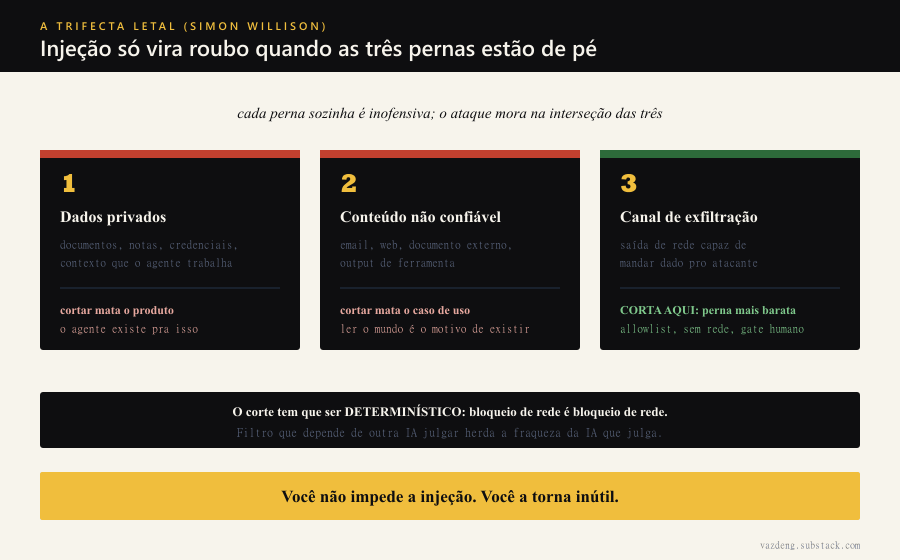
O modelo mental que organizou isso pra mim é a trifecta letal, framing do Simon Willison. Um sistema com LLM vira alvo real quando reúne três coisas ao mesmo tempo: acesso a dados privados, exposição a conteúdo que você não controla, e um canal de saída capaz de mandar dados pra fora. Cada perna sozinha é inofensiva. Um agente que lê seus documentos mas não tem rede não vaza nada. Um agente exposto à web mas sem dado sensível não tem o que entregar. O roubo de dados acontece na interseção das três.
Por que detectar toda injeção é batalha perdida
Em SQL injection o problema foi resolvido há décadas com sanitização: caractere especial tem escape, comando vira literal. Linguagem natural não tem caractere especial. A instrução maliciosa pode ser um parágrafo educado no meio de um email legítimo, e o modelo não tem fronteira sintática entre “conteúdo que estou lendo” e “instrução que devo seguir”. Filtros ajudam, mas quem promete detecção completa está vendendo uma corrida armamentista como se fosse produto acabado.
Aceitar isso muda a pergunta de engenharia. Em vez de “como bloqueio toda injeção”, a pergunta vira “qual perna da trifecta eu corto”. E aí a economia da defesa fica clara. Cortar dados privados mata o produto: o agente existe pra trabalhar com seu contexto. Cortar conteúdo não confiável mata o caso de uso: ler email, web e documento é o motivo de o agente existir. Sobra a terceira perna. A saída de rede é a mais barata de restringir sem inutilizar o sistema, e é exatamente onde dá pra aplicar controle que não depende de julgamento.
O que o Lockdown Mode acerta
A OpenAI transformou esse raciocínio em produto: o Lockdown Mode, expandido pros planos pessoais do ChatGPT no início de junho de 2026, limita as requisições de rede de saída que poderiam transferir dado sensível pra um atacante. O detalhe que mais me interessa não é o recurso em si, é o critério: os mecanismos são determinísticos. Bloqueio de rede é bloqueio de rede. Não existe um segundo modelo avaliando se a requisição “parece maliciosa”, porque um filtro que depende de outra IA julgar herda a fraqueza da IA que julga. Um ataque esperto o suficiente pra enganar o modelo principal pode enganar o modelo guardião.
Tem uma admissão implícita aí que vale registrar: se foi preciso criar um modo de bloqueio, a configuração padrão não oferece proteção robusta contra exfiltração determinada. E a própria OpenAI posiciona o recurso pra quem tem perfil de risco elevado, porque o corte de saída tem custo real de funcionalidade.
Como eu aplico isso nos meus agentes
Nos agentes que rodo sobre minha base pessoal de notas e projetos, o checklist que uso antes de dar qualquer ferramenta nova é mapear a trifecta: esse agente lê dado privado? Consome conteúdo que não controlo? Tem canal de saída? Quando as três respostas são sim, eu corto a saída: allowlist de domínios, ferramenta sem rede quando a tarefa permite, e gate humano em qualquer ação que atravesse a fronteira do sistema. Guardrail baseado em LLM eu trato como camada extra de defesa em profundidade, nunca como a defesa.
O limite do modelo também precisa ser dito: cortar a saída não impede a injeção de acontecer, só a impede de valer alguma coisa. E se o seu agente precisa de saída ampla, um agente que publica conteúdo, por exemplo, o corte muda de perna: isole os dados privados da sessão que toca conteúdo não confiável. A trifecta não diz qual perna cortar. Diz que, enquanto as três estiverem de pé, você está exposto.
Segurança de agente em 2026 não é pureza. É pragmatismo: escolher a perna mais barata e cortar com mecanismo que não pode ser convencido do contrário.