Em junho o pipeline editorial que roda este blog quase publicou dois posts de Airflow em nove dias. A checagem de repetição existia, só que morava no lugar errado: eu pedia pro modelo “lembrar” se o tema já tinha saído. Ele respondia com confiança, e a confiança não tinha lastro nenhum. A correção não foi um prompt melhor. Foi tirar a pergunta do LLM: hoje um passo determinístico varre o histórico publicado em disco e bloqueia tema repetido antes de qualquer geração começar.
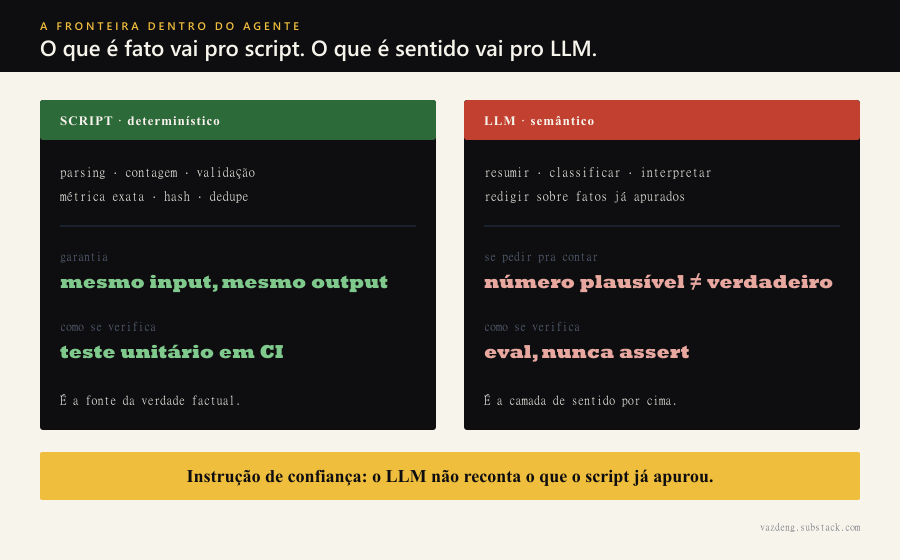
Foi com esse episódio que aprendi na prática a fronteira que hoje considero a decisão de arquitetura mais importante num agente: separar computação determinística de julgamento semântico. Parsing, contagem, validação de integridade, cálculo de métrica, deduplicação contra histórico: tudo que tem resposta exata e verificável vai pro script. Barato, reproduzível, testável em CI. Resumir, classificar intenção, interpretar um resultado, escrever o relatório: o que exige leitura de contexto é o único lugar onde o LLM entra.
O bug que a fronteira previne
Pedir pro modelo fazer o trabalho do script convida um tipo específico de defeito: a alucinação de número. “Conte quantas funções chamam X” devolve um valor plausível, não um valor verdadeiro. E plausível é pior que errado, porque passa numa revisão desatenta. O time por trás do PMAx, framework de process mining com agentes do grupo do van der Aalst, escreve isso sem rodeio no paper: “LLMs struggle with deterministic reasoning and may hallucinate metrics”. A arquitetura deles separa um agente Engineer, que gera scripts locais e computa as métricas exatas, de um agente Analyst, que só interpreta os artefatos prontos. Computação de um lado, interpretação do outro, nunca os dois no mesmo papel.
O exemplo mais literal dessa fronteira que eu vi até hoje é o Understand-Anything, projeto open source com mais de 77 mil estrelas que transforma codebase em grafo de conhecimento. O Tree-sitter parseia o fonte e extrai os fatos estruturais: imports, definições, call sites. “Same input, same output, every run”, nas palavras do próprio projeto. O mapa de imports sai pronto e é entregue aos analisadores de arquivo justamente pra que não re-derivem os imports do código. O LLM entra depois, pra produzir o que parser nenhum produz: resumo em linguagem clara, tags, atribuição de camada arquitetural.
A instrução de confiança
Dividir o trabalho não basta. O que separa um agente sério de um brinquedo é a segunda metade do padrão: o LLM recebe os fatos apurados pelo script como verdade-base e é proibido de recalcular. Quando o script já garantiu o fato, mandar o modelo reconferir não adiciona segurança. Adiciona variância, custo de token e uma chance nova de erro.
Uso essa régua em tudo que construo. O validador de pautas deste blog é um pipeline determinístico: gate eliminatório, score ponderado, auditoria de quatorze dias contra o histórico real em disco. A geração do texto, que é julgamento, só começa depois que os fatos passaram no gate. O texto nunca discute com o número que o script cravou.
Onde a régua escorrega
A fronteira tem limites, e dois já me morderam. Primeiro: se o fato não é formalizável, não existe script pra delegar. “Esse requisito está bem escrito?” é julgamento; forçar um regex ali produz falso rigor. Segundo: a instrução de confiança é faca de dois gumes. Se o script tem bug, o LLM propaga o erro com confiança total, sem reparo no caminho. “Confie no script” pressupõe “o script tem teste”. E o contrato entre os dois, o formato do artefato que o script entrega, vira interface crítica: mudou o schema e ninguém atualizou o prompt do intérprete, quebra silencioso. Trato essa fronteira como API versionada.
Vale dizer quando o padrão não paga: num one-off exploratório que roda uma vez, aceitar a imprecisão do modelo pode custar menos que escrever, testar e versionar o script. O ganho aparece quando a tarefa é recorrente e entra em CI. Pro resto, a regra que fica é curta: o script é a fonte da verdade factual. O LLM é a camada de sentido por cima dela. Nunca o contrário.