Quando a Spotify soltou agentes de código no monorepo de backend, o repositório único onde vive a maior parte do serviço, a expectativa era de problema. Niklas Gustavsson, da engenharia da Spotify, admitiu isso na entrevista ao canal da Anthropic que passou pelo meu pipeline de curadoria em julho: ferramentas anteriores sofriam com indexação em repositório grande, e o deles passa de 20 milhões de linhas. Aconteceu o oposto. O agente funciona surpreendentemente bem ali, e o motivo é quase irônico: ele usa o resto do repositório como inspiração. Quanto mais código consistente por perto, melhor a solução que ele propõe.
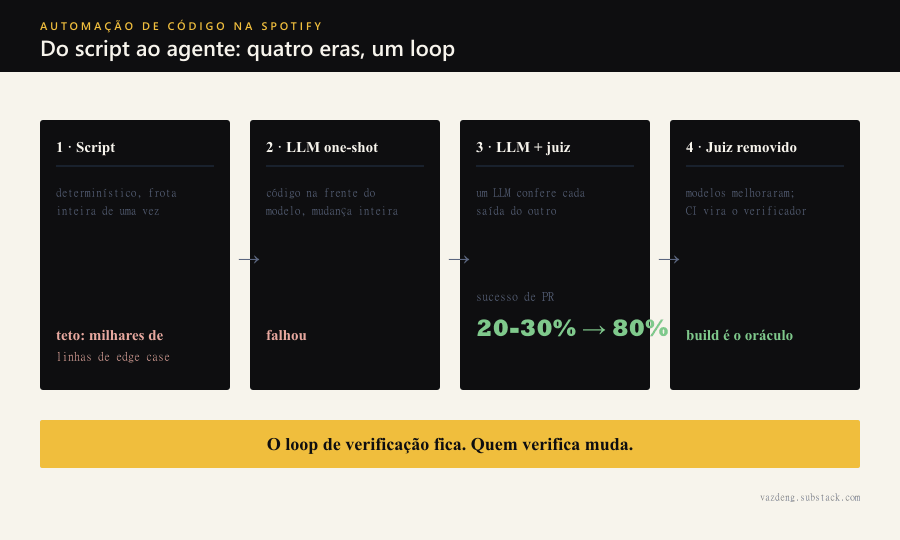
Essa história começa antes dos LLMs. Há uns cinco ou seis anos a Spotify percebeu que o codebase crescia sete vezes mais rápido que o número de engenheiros (hoje são 2.900). Migração de framework era tortura: centenas de times repetindo a mesma operação manual em milhares de componentes, meses por migração, umas dez por ano no total. A resposta foi o que eles chamam de fleet management, gestão de frota: em vez de pedir pra cada time migrar o seu pedaço, aplicar a mutação no codebase inteiro de uma vez, por automação. Milhões de PRs automatizados foram mergeados assim.
O teto do script e o juiz que se aposentou
Só que os scripts determinísticos de migração bateram num teto. Código tem uma superfície de API enorme: a mesma chamada aparece de cinco jeitos, atribuída a variável, encadeada, embrulhada. Cada script virava milhares de linhas de tratamento de edge case. Foi esse teto que empurrou a Spotify pros LLMs, e a primeira tentativa, jogar o código na frente do modelo e pedir a mudança inteira de uma vez, falhou. O que destravou foi decompor o problema e colocar um LLM juiz conferindo cada saída: a taxa de sucesso dos PRs subiu de 20-30% pra 80%.
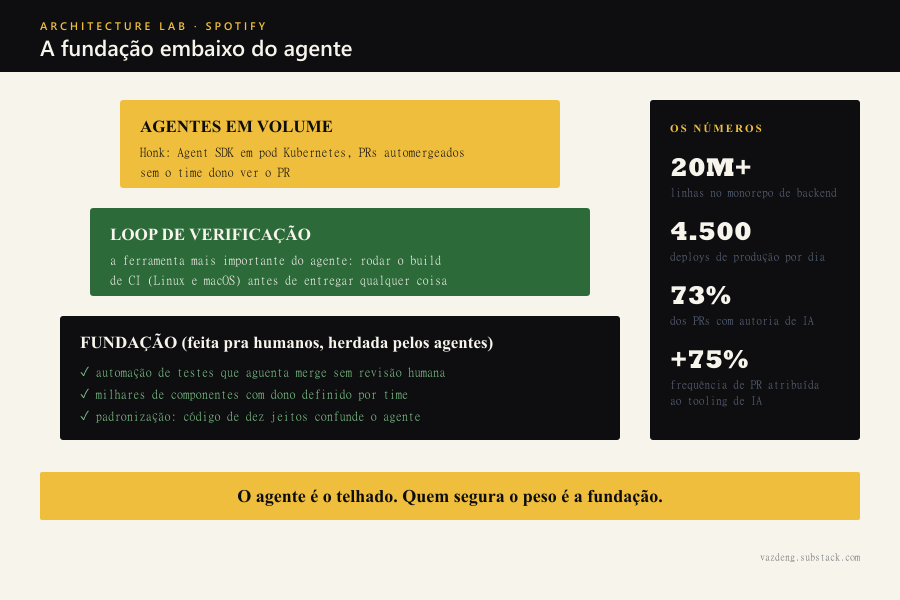
E vem o detalhe que mais me interessou na entrevista inteira: depois eles removeram o juiz. Modelos e harness melhoraram a ponto de o juiz virar peso morto. O que ficou no lugar não foi fé no modelo, foi verificação de verdade: o Honk, o agente que eles construíram sobre o Agent SDK rodando em pod Kubernetes, tem como ferramenta mais importante o poder de rodar o build de CI, em Linux e macOS, antes de entregar qualquer coisa.
A fundação embaixo do agente
O que sustenta esse sistema não é o agente, é o chão embaixo dele. Pra automergear a maioria das mudanças (merge sem aprovação humana), sem o time dono sequer ver o PR, a Spotify precisou primeiro reforçar a automação de testes a ponto de o software sobreviver a mudança que ninguém revisou. Precisou dividir o codebase em milhares de componentes com dono definido. E precisou de padronização: nas palavras do Gustavsson, se o mesmo problema aparece resolvido de dez jeitos diferentes no repositório, o agente se confunde mais. São investimentos feitos pra humanos anos antes, que transferiram direto pros agentes. O resultado composto: são 4.500 deploys de produção por dia, 73% dos PRs com autoria direta de IA e frequência de PR 75% maior, atribuída ao tooling.
Quando não copiar
O anti-padrão é copiar o telhado sem a fundação. Já vi essa tentação de perto: ligar um agente em cima de um sprawl de repositórios sem padrão, com uma suíte de teste que o próprio time não confia, e ainda sonhar com auto-merge. Agente amplifica o que existe. Se o CI não serve como oráculo de verificação, o loop fecha em cima de mentira e o volume de PR só multiplica o risco. Quando não copiar a Spotify: se os seus testes não seguram uma mudança feita sem revisão humana, se cada serviço tem estilo próprio, se ninguém sabe quem é dono do quê. Essa é a ordem de investimento, não a de compra de ferramenta.
Pra quem está numa fintech ou scale-up brasileira decidindo mono versus poly em 2026, a lição que eu levo é que a pergunta mudou. Não é qual layout de repositório o agente prefere; as 20 milhões de linhas provam que tamanho não é o gargalo. É se as suas práticas de engenharia aguentam um ator novo produzindo mudança em volume. O conselho final do Gustavsson resume: as práticas sãs de antes continuam valendo. O agente só cobra, com juros, as que você pulou.